HarnessTax:成功率几乎不动,壳却能让你多付一倍
大家好,我是珂抖屁。
一人公司买 Agent,发票上写的是模型名,真正从账户里扣钱的,常常是 harness——壳。系统提示有多长、工具 schema 有多厚、每轮往上下文里塞多少「脚手架」,都会变成 token 税。税高不高,榜单上的成功率未必告诉你。
Ion Stoica(@istoica05)转发并点名的一组公开评测,把话说得很刺:他们把 7 个模型 放进 Claude Code / Codex / Pi 三套编码壳里跑,发现一个扎眼的结果——壳对任务成功率影响不大,对成本影响很大。 Melissa Pan 等人的公开线程把它叫成 hidden 「harness tax」。
这篇文章只做一件事:把公开结论讲明白,并落到一人公司的采购口径——采购单元该是 harness,而不只是模型名。
公开数字先摆上桌(并写清出处)
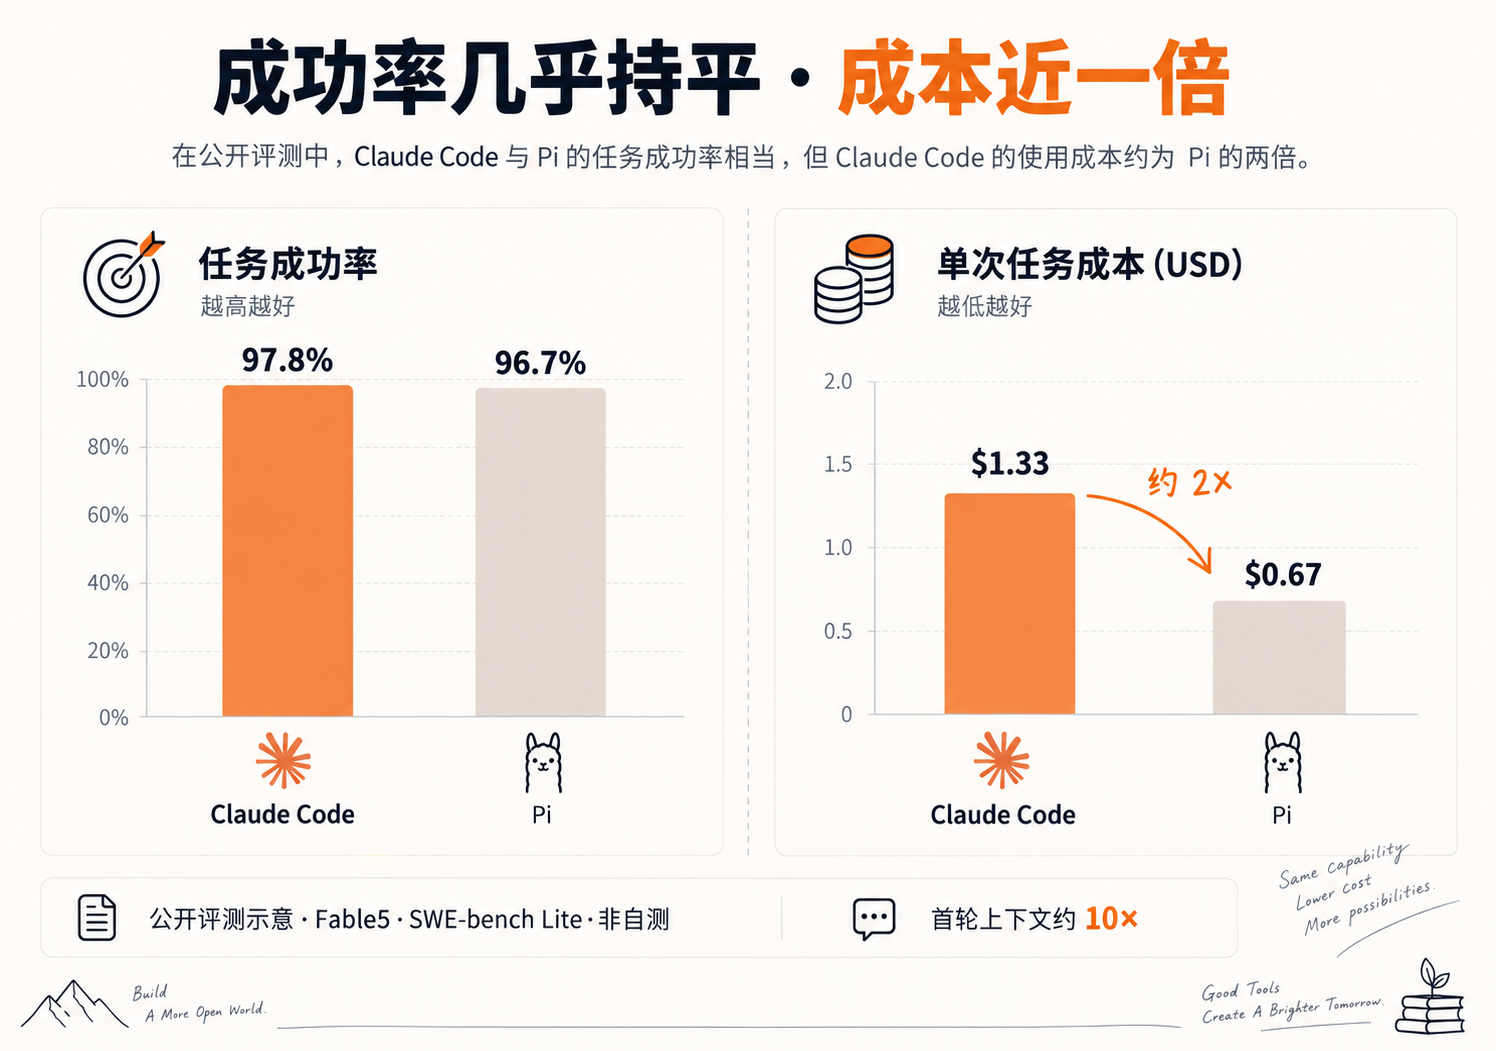
公开评测示意·Fable5·SWE-bench Lite·非自测。
以下数字来自评测方公开线程(Melissa Pan 等;Ion Stoica 转发),不是我自测:
在 SWE-bench Lite 上,以 Fable 5 为例:
•Claude Code:约 97.8% 成功率,约 $1.33 / rollout
•Pi:约 96.7% 成功率,约 $0.67 / rollout
成功率只差约 1.1 个百分点,成本却接近 一倍。线程还写:两侧平均轮次几乎一样(约 15.3–15.4 轮),但 Claude Code 首轮上下文均值超过 Pi 的约 10 倍——更长的指令、更大的工具 schema,是「税」的一个可见来源。
评测方同时强调:Claude Code 仍可能站在该基准的成功率前沿;但 Pi / Codex 常能在相近成功率下更省钱。若你只按成功率选壳,就可能默默多付 harness tax。
(再次声明:这是公开评测/报道口径;换数据集、换模型档位、换定价,数字会变。一人公司拿它当「方向标」,别当「我的账单保证单」。)
三个结论:壳、简、原生
公开线程把发现收成三条,我用一人公司语言翻译一下。
1. 壳主要改的是成本曲线斜率,不是智力开关 同一模型换壳,成功率常常差不多;贵不贵,差很多。采购时如果只锁「模型智商」,会漏掉最大的浮动项。
2. 简单壳可以很能打 Pi 被描述为主要靠 read / write / edit / bash 四个工具,仍能走到公开基准的帕累托前沿附近。这说明:日常编码 Agent 未必需要无限加工具挂件。挂件越多,schema 越厚,税越重。
3. 「原生壳」不一定最好 线程举例:某些 GPT 路线在 Pi 上成功率可以高于在 Codex 上;某些 Opus 路线在 Codex 上可以高于在 Claude Code 上。模型与壳共同训练的故事很性感,但跨壳泛化在今天的公开结果里成立——别迷信「官方壳 = 官方最佳」。
三条合起来,打掉的是一种采购迷信:贵壳 = 更强,官方壳 = 最配。 更强的可能是「刚好够用的壳 + 选对的模型」。
税从哪里来:轮次相同,账单不同
最反直觉的,是「轮次差不多,钱差一倍」。一人公司容易误判成:贵的壳一定多干了活。公开解释指向另一件事:
•每轮携带的 固定上下文(长系统提示、大工具表)
•工具结果的序列化与回灌方式
•harness 自己的记账与摘要策略
于是出现典型账单结构:模型推理费 + 脚手架费。脚手架费不出现在产品海报上,但出现在月末。
相关公开讨论里,也有团队在别的模型/自托管设定下观察到:换壳可让同任务花费差到接近一倍量级(例如 aistack 对 Claude Code / Codex / Pi 的成本对照)。方向一致——壳是一等公民成本项。
你若只看「成功了没」,会觉得大家都差不多;若看「成功一次要花多少」,壳的差距会突然变得很难忽略。
一人公司怎么采购:把 harness 写进单元
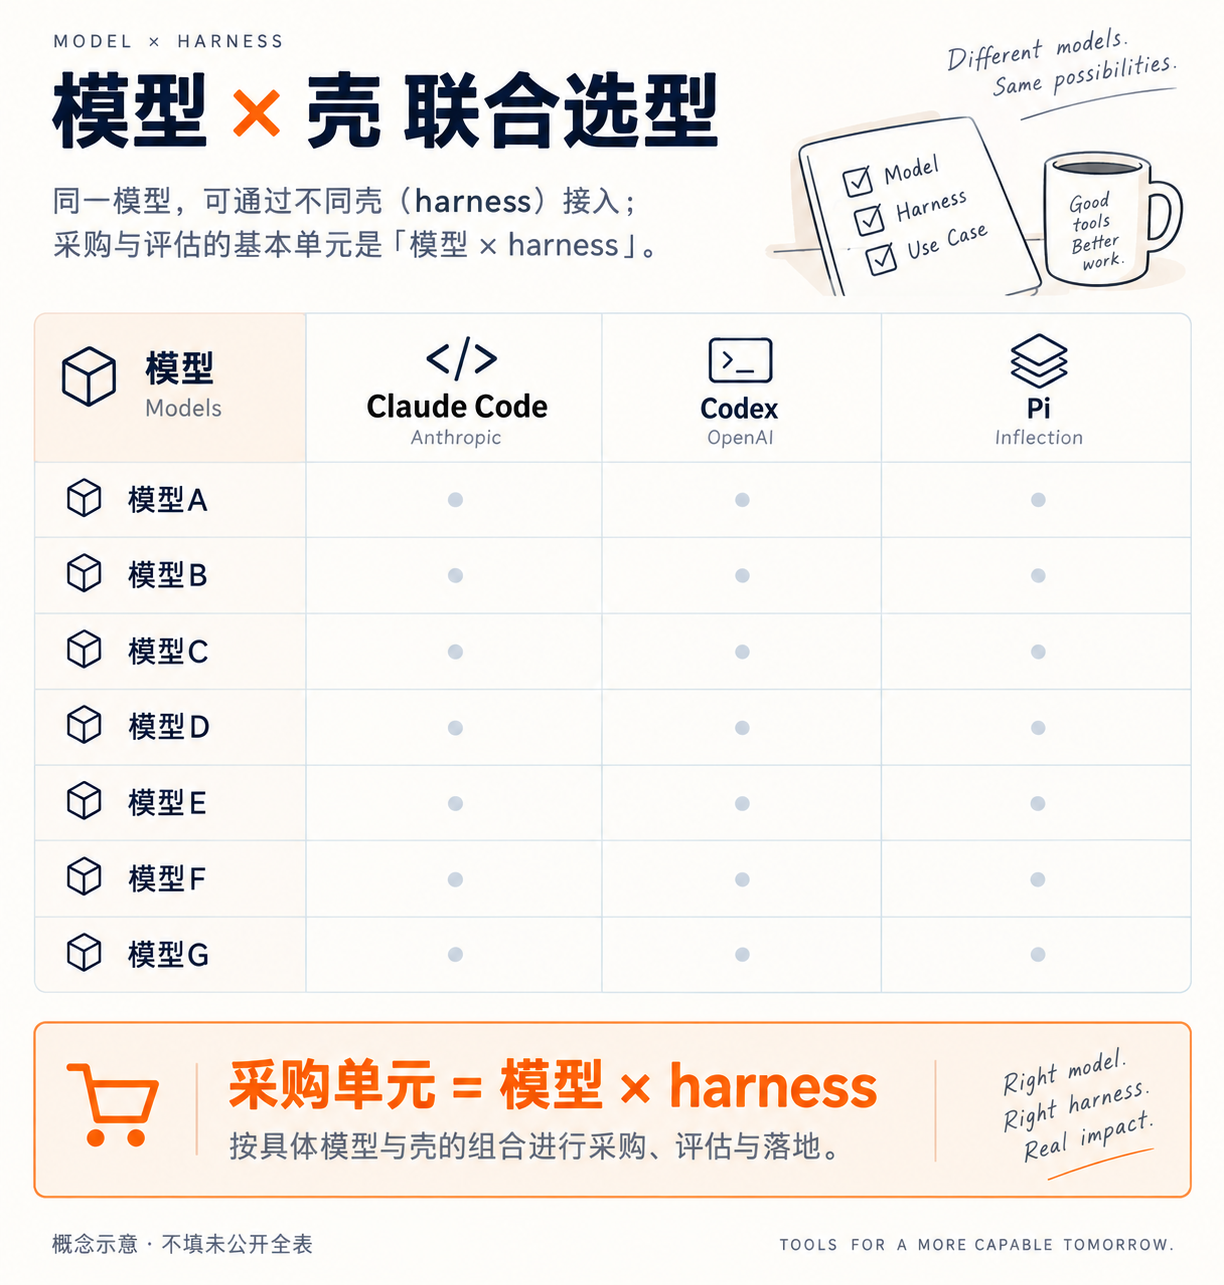
模型 × 壳联合选型概念图;未公开全表数字不填。
我给自己的采购表,只留四行:
| 采购问题 | 别再只问 | 改问 |
|---|---|---|
| 聪明吗 | 唯一切换模型 | 模型 × 壳 的成功率是否够用 |
| 贵吗 | 看官方标价 | 同任务下三壳账单差多少 |
| 稳吗 | 看演示 | 默认权限、可重复性、失败是否可恢复 |
| 绑死吗 | 品牌忠诚 | 换壳迁移成本(指令文件、MCP、CI) |
操作上更具体三点:
•默认壳选「够用且安静」的,高峰任务再上重壳。
•评测自己的高频任务 10–20 条,比背 SWE-bench 更有用;公开数字只负责叫醒你。
•合同与预算按「模型+壳」打包,否则财务只看见模型名,技术债在壳上。
再补一条现场纪律:新壳上线先跑「只读 + 小改」一周,再开大重构。税要量,风险也要量。
什么时候该付税
不是所有税都该逃。公开线程也区分了场景:
•日常编码接口:模型越强,越可能少需要花活脚手架 → 优先成本与可靠性。
•能力边界上的难题(科研、超复杂编排):结构化更强的壳仍可能值回票价。
一人公司的经验法则:日更任务逃税,尖端任务付税。 把「重壳」当成偶发武器,而不是默认桌面。
付税的正当理由通常长这样:你需要更强的权限门禁、更完整的审计、更稳的多代理协调、或明确更高的尖端成功率。若只是「默认就很厚」,那更像习惯,不像投资。
读公开评测时,一人公司要防的三种误读
误读一:把某一个模型的例子当成所有模型的定律。 线程里的 $1.33 与 $0.67,明确挂在 Fable 5 + SWE-bench Lite 上。换模型,税差可能更大,也可能更小。
误读二:以为省钱壳一定更弱。 公开结论的刺点,恰恰是成功率几乎不动。弱不弱,要看你的任务分布,不是看账单是否好看。
误读三:看见「原生壳不一定最好」就立刻全家迁移。 迁移本身有税:指令文件、权限、CI、同事习惯。正确动作是并行抽样,而不是昨夜激情重装。
把这三条贴在显示器边,你就不容易被一张对比图带跑。评测负责叫醒;你的抽样负责决策。
和今天另外两条新闻的合读
同日附近还有两股噪音:DeepSeek Harness 在推远程 / 组队 / 界面控制的工作台;编码默认壳有人从 Claude 侧切向 Codex。HarnessTax 把底层逻辑补全了——
•工作台在变厚(能力)
•默认壳在换手(手感)
•税表提醒你:厚与贵不是一回事,手感与账单也不是一回事
选壳时同时看三列:成功率、$/任务、日摩擦(废话与确认)。少一列,都会在月末或情绪上还款。
写在最后
模型是引擎,harness 是变速箱和车身。公开评测最有用的一句话,不是「某壳垃圾」,而是:请把模型与壳一起选。
对一人公司,我把口号落成可执行的一句:
采购单元 = 模型 × harness;成功率差不多时,优先打掉 harness tax。
下次有人只甩一个模型名跟你报价,你可以礼貌地回一句:壳呢?成功率呢?单次任务成本呢?三问齐,才像 2026 年的采购。
(依据:@istoica05 公开帖;Melissa Pan 等公开线程关于 7 模型 × Claude Code / Codex / Pi、SWE-bench Lite 上 Fable 5 的约 97.8%/$1.33 vs 约 96.7%/$0.67,以及首轮上下文约 10× 等说明。文中数字均为公开评测口径,非本号自测。)