Jev 不说话:TypeSafe 的 System One,是给软件用的决策模型
大家好,我是珂抖屁。
这几天 HN 和中文圈又在刷一个名字:Jev。刷屏点很怪——它几乎不跟你聊天。没有长篇散文,没有「让我来帮你想想」。按官方口径,它吐出来的是软件能直接 if 的东西:带概率的类型化决策。
社区里有人把它比成「带概率的智能 if」。我觉得这个比喻脏,但准。方向可能真,营销数字要打折。下面按公开材料拆清楚:它是什么、能干啥、和 GPT/Claude 差在哪、一人公司怎么摆进班底。
它是什么:System One,不是又一个聊天模型
TypeSafe AI 在约 2026-09-15 前后放出首个公开的 System One 模型,叫 Jev。类名借自卡尼曼的 System 1(快直觉);产品名则致敬杰文斯——官方叙事是:智能变便宜,用量会暴涨,像当年煤炭。
公开报道称,创始人一脉常被提到 Diogo Almeida(RLHF / InstructGPT 相关背景)。我只把它当背景标签,不替任何人背书履历。
关键设计,官方写得很硬:
•不是文本生成器。输入是 state(文本 / JSON / 数组)+ 一组类型化问题;输出是软件可直接消费的概率决策。
•问题在一次前向里并行求值,不是逐 token 自回归吐字。
•训练叙事叫 RLCD(Reinforcement Learning for Calibrated Decisions):对「校准过的决策」做强化,而不是 RLHF 那种偏好长文。这是公司故事,当作产品哲学理解即可。
三种问题类型(公开文档):
•Noul:是/否,吐 0–1 概率
•Choice:N 选 1(公开材料写到约 255 选项)+ confidence + 各选项概率
•Score:2–10 档有序量表上的位置 + confidence + 各档概率
一句话:你先把决策空间钉死,它在空间里投票并报置信度。
它能干什么:路由、分诊、打分、护栏
适合挂在流水线里、每分钟要踩无数次的节点:
•路由:工单进账单 / 技术 / 销售哪条线
•分诊:要不要人工、要不要升级、要不要拒掉
•风险 / 紧急度打分:有序档位,方便阈值门槛
•Agent 护栏:动作执行前做「是否违规 / 是否越权」的廉价闸门
官方演示语言里常见:约 70–500ms 延迟、输入约 $0.042/MTok、输出免费。速度与成本上「百倍级」之类倍数,出自他们自己的工作流评测——请当成官方宣称与特定评测,不是物理定律。
官方还爱说「similar intelligence on System One-shaped tasks」相对前沿 LLM。意思是:在被裁成决策题的任务上接近,不是全面碾压聊天模型。
和 GPT / Claude / Gemini 差在哪;也别当成经典分类器
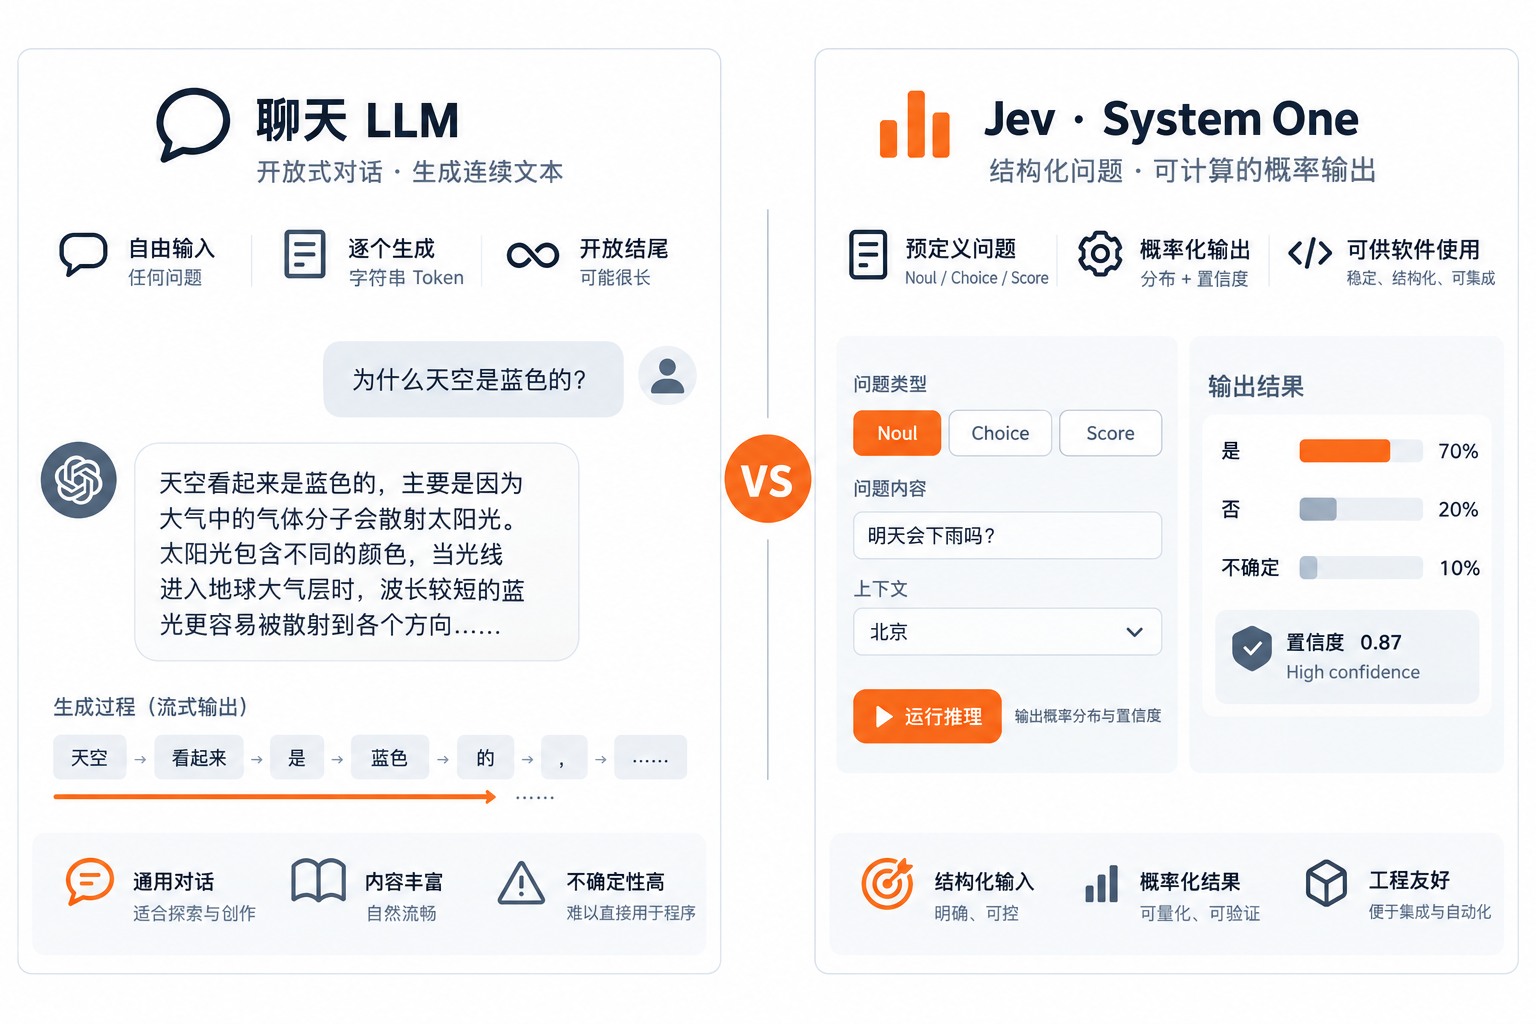
对比示意:聊天 LLM 吐字符串;Jev 吐可 if 的类型化概率。
和对话大模型比:
| 聊天 LLM | Jev(System One) | |
|---|---|---|
| 接口形状 | 生成字符串 | 类型化答案 + 概率 |
| 解码 | 自回归逐 token | 并行回答多题 |
| 典型职责 | 写作、开放推理、硬少数题 | 路由 / 分诊 / 护栏 |
和经典分类器比:它吃非结构化 state,问题用自然语言写准则,一次可并行多题,还带置信度。比训一堆 sklearn 管线更像「可编程的决策层」;但别神话——你定义的选项烂,它只能在烂选项里挑。
再钉一句官方最容易被误读的口号:「Zero hallucination」。按构造,它发不出错误类型 / 错误 schema——不会给你一个不在 Choice 列表里的标签。这不等于不会选错。合法答案里选错,照样炸业务。把「schema 正确」说成「事实正确」,是文字游戏风险。我自己落地时,会把 confidence 低的分支强制交给 LLM 或人。
一人公司 / Agent 班底里怎么摆
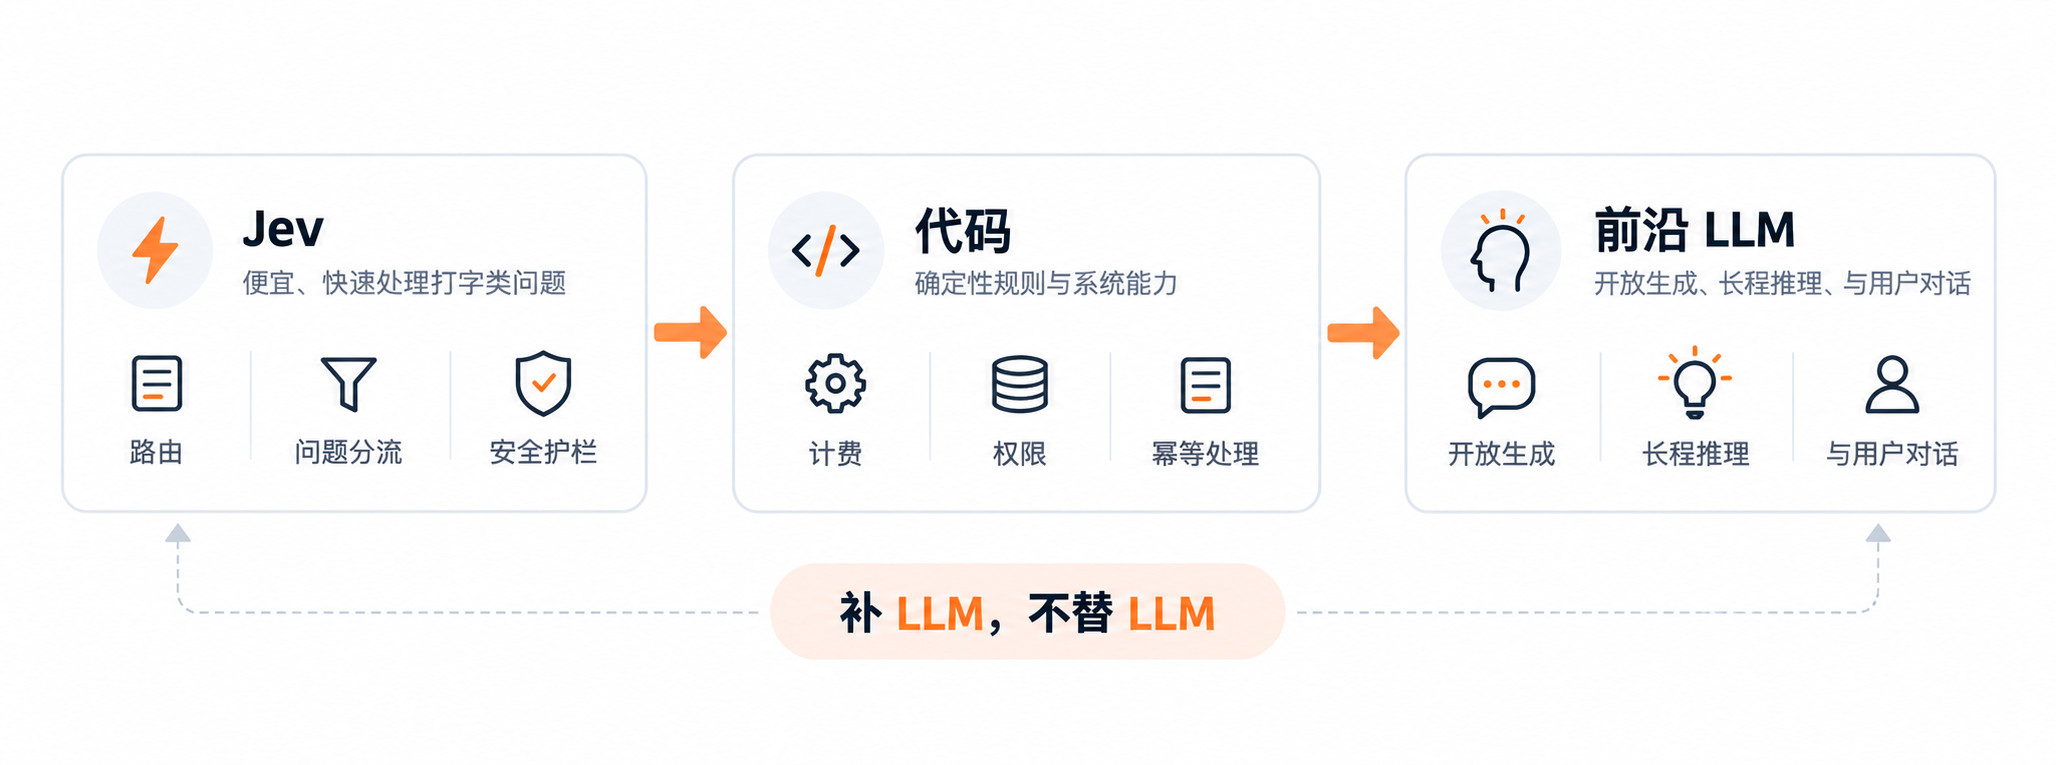
合理 cascade:Jev → 代码 → 前沿 LLM;补 LLM,不替 LLM。
官方定位很清楚:补 LLM,不替 LLM。 合理 cascade:
•Jev:便宜、快、结构化——路由、分诊、护栏、阈值闸
•代码:确定性规则、计费、权限、幂等
•前沿 LLM:开放生成、长推理、难少数、对用户说话
公开路径包括 TypeSafe API 的 POST .../v1/systemone,以及 Cloudflare / OpenRouter / Vercel AI Gateway 上公开文档写到的接入方式(含 experimental_evaluate 一类路径)。early access 阶段,等名单和网关旁路并存——以你当下能通的公开文档为准。
我自己的判断:一人公司里,Agent 最贵的往往不是「会不会写」,而是会不会乱路由、乱调用、乱花钱。Jev 这种形状,天生适合当班底里的廉价门卫;写稿、写代码、跟客户解释,还是交给会说话的模型。
按特性:能落哪些行业、干什么
Jev 的硬特性就四条:决策空间先钉死、一次并行多题、吐概率与置信度、延迟短到能塞进同步链路。所以行业不是「谁都能聊天」,而是「谁天天有海量、重复、可枚举的判断」。
下面按行业写能干什么——都是 Choice / Score / Noul 形状,不是让它写报告。
客服与售后
•工单路由:账单 / 技术 / 物流 / 投诉
•紧急度与情绪档:是否插队、是否升级人工
•退款/换货预审:是否命中政策关键词、是否可疑套利
金融与支付风控
•交易/账户风险分档:放行 / 加强验证 / 拦截
•进件与 KYC 材料齐套性:缺哪类材料(选项枚举)
•客诉是否涉及监管口径:是否需合规人工
(阈值与合规仍由代码与人审钉死;Jev 只做廉价预分诊。)
电商与内容审核
•商品类目 / 违禁倾向粗分
•UGC 是否需人审:色情、引流、虚假宣传等标签
•售后原因归类:质量 / 物流 / 期望差
医疗与健康运营(非诊疗)
•咨询分诊到科室/客服队列(选项必须业务自建)
•是否「急诊措辞」触发加急人工
•预约改期原因归类
不替代诊断;只做流程分流。
企业 IT / SaaS / Agent 班底
•告警是否噪音、是否该 page 人
•Agent 动作护栏:是否越权、是否外发、是否改生产
•工单优先级与归属团队
一人公司最贴身的,往往是这一块:让贵模型少踩冤枉闸门。
人力与招聘
•简历粗分:岗位匹配档、是否进入下一轮
•候选人来源渠道归类
•面试反馈情绪/完整度打分(有序量表)
政务与公共事务运营(若有明确选项库)
•诉求类型路由:社保 / 户籍 / 城建…
•是否敏感舆情需升级
选项库必须本地法务审过;模型只在白名单里挑。
我怎么挑行业场景
问三句就够:
•答案能不能事先写成有限选项?
•错了能否用「低置信度 → 人工/LLM」兜住?
•一天是否要判成千上万次,以至于延迟和单价真的疼?
三句都「是」,Jev 形状才赚;任一句「否」,先别硬上。
什么时候用,什么时候别用
用:决策空间能事先钉死;要概率与门槛;调用极频繁;失败代价可用「低置信度升级」兜住。
别用:要散文、要开放探索、要创意、要解释给人类听;选项本身定义不清;把「schema 安全」当成「业务正确」。
方向我认:软件要的是值,不是小作文。数字我打折:延迟、单价、倍率都以官方 demo 与自家评测为准,上线前用你自己的 state 量一遍。若它真把「决策层」从聊天里拆出来,一人公司的 Agent 班底会少烧很多冤枉钱——前提是你别被「零幻觉」四个字催眠。